Orchestration des données
L’orchestration des données automatise leur déplacement, leur transformation et leur gouvernance au sein de pipelines complexes de données et d’IA.
L’orchestration des données désigne la coordination, la transformation et le déplacement automatisés des données entre différents systèmes, pipelines et environnements. Elle garantit que les données sont collectées, standardisées, gouvernées et transmises de manière fiable aux outils d’analyse, aux applications et aux charges de travail d’IA.
Qu’est-ce que l’orchestration des données ?
L’orchestration des données supervise l’ensemble du cycle de vie des données — de leur ingestion et leur transformation jusqu’à leur activation et leur diffusion dans les lacs de données, les entrepôts de données, les systèmes opérationnels et les pipelines d’IA. Elle automatise les workflows qui remplacent les transferts manuels et les scripts cloisonnés, garantissant ainsi que les données restent exactes, à jour et formatées de manière cohérente dans les environnements distribués.
Orchestration des données, intégration des données et ETL : quelles différences ?
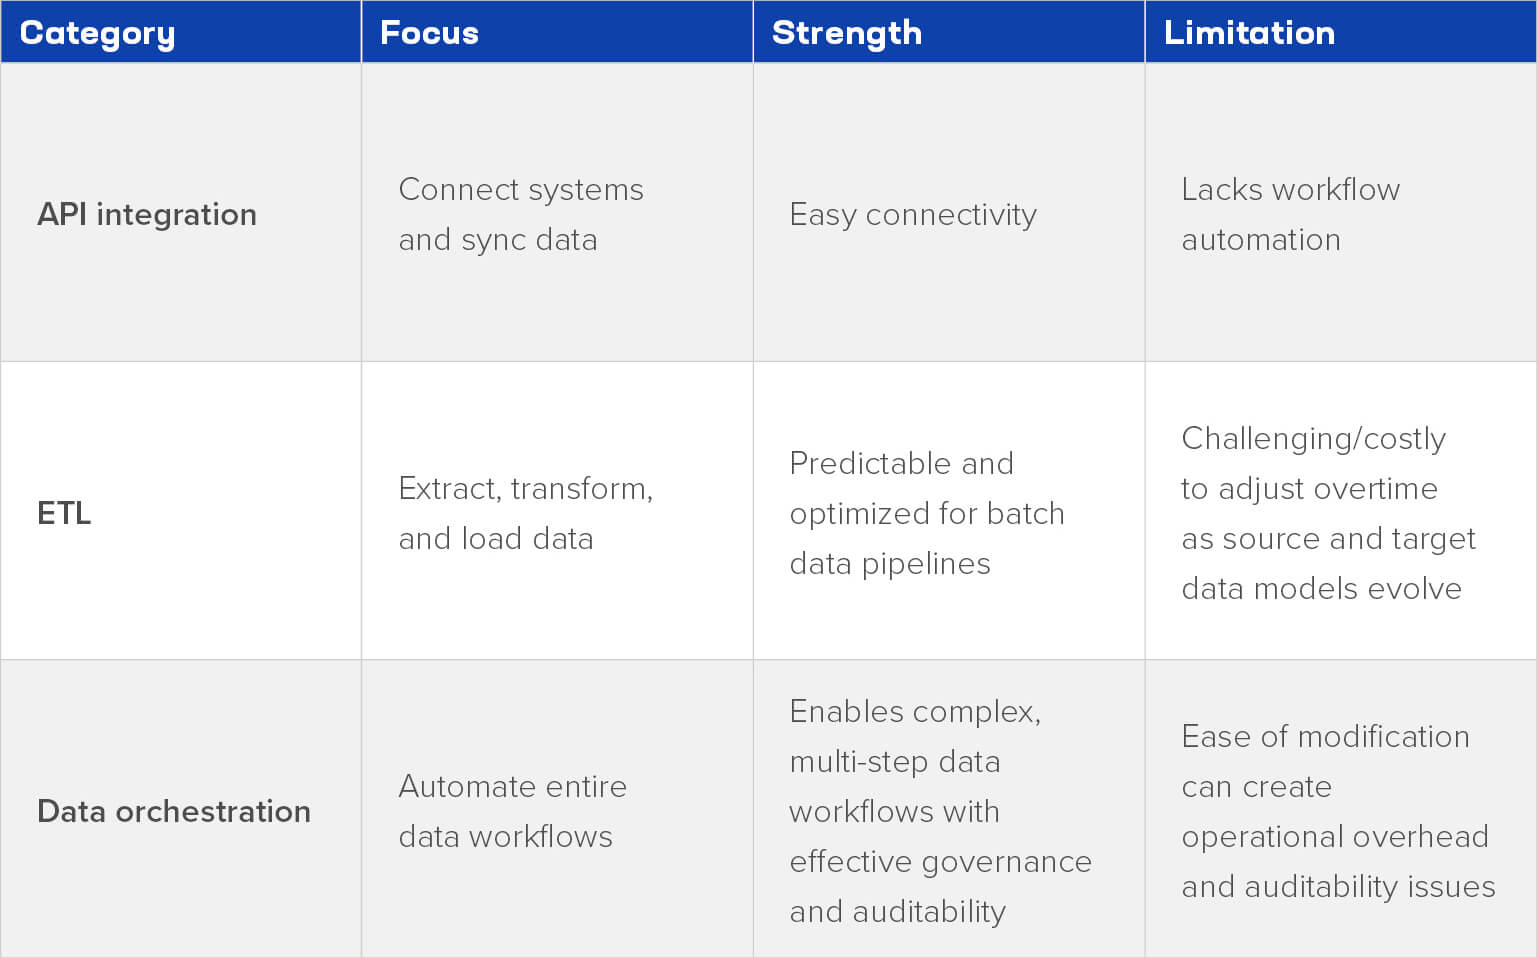
L’intégration de données combine des données provenant de plusieurs sources, mais se concentre généralement sur la connectivité. Les outils ETL extraient, transforment et chargent les données dans les systèmes cibles, souvent en mode batch.
L’orchestration des données coordonne tous les workflows de données, notamment le traitement par lots, le streaming, le multicloud, l’analytique et l’IA, afin de garantir leur exécution dans le bon ordre, avec les niveaux requis de qualité, de gouvernance et de supervision.
Les piles de données modernes reposent sur l’orchestration des données
À mesure que les organisations étendent leurs déploiements multicloud, leurs analyses en temps réel et leurs applications basées sur l’IA, le volume et la vitesse des données dépassent les capacités des processus manuels. L’orchestration des données garantit que les pipelines fournissent en continu aux systèmes en aval des données gouvernées et de haute qualité à traiter.
L’orchestration de l’IA s’appuie sur l’orchestration des données
L’orchestration des données est un pilier de la gestion des données ; elle englobe les workflows de données, la collecte et le nettoyage des données, ainsi que le transfert des données exploitables. L’orchestration de l’IA étend l’orchestration des données à l’ensemble du cycle de vie du machine learning (ML), notamment à la coordination des pipelines de caractéristiques (spécifiquement structurés pour les prédictions), à l’entraînement des modèles (planification des ressources et gestion des jeux de données), au déploiement des modèles, au suivi de leur dérive et de leur précision, ainsi qu’aux boucles de rétroaction permettant de les réentraîner ou de les ajuster.
Pourquoi l’orchestration des données est-elle importante ?
L’orchestration des données offre plusieurs avantages aux entreprises :
- Améliore la fiabilité et la qualité des données : Standardise les données provenant de différentes sources, applique les politiques de gouvernance et garantit leur transmission cohérente aux systèmes d’analyse et d’IA.
- Accélère les pipelines de données et d’IA : Automatise l’enchaînement des workflows et la gestion des erreurs, réduisant ainsi la charge de travail manuelle des équipes d’ingénierie.
- Favorise l’obtention d’informations en temps réel : Prend nativement en charge les workflows de streaming et basés sur des événements, permettant ainsi une prise de décision rapide.
- Renforce la gouvernance et la conformité : Utilise les métadonnées pour le suivi (sources, modifications et avancement), la traçabilité (pistes d’audit) et les contrôles d’accès (application des règles) afin d’aider les équipes à respecter les exigences réglementaires et de sécurité.
- S’adapte aux environnements multicloud et hybrides : Orchestre les données au sein d’architectures distribuées sans recourir aux intégrations traditionnelles, fragiles et point à point des systèmes existants.
Comment fonctionne l’orchestration des données ?
L’orchestration des données suit généralement quatre étapes :
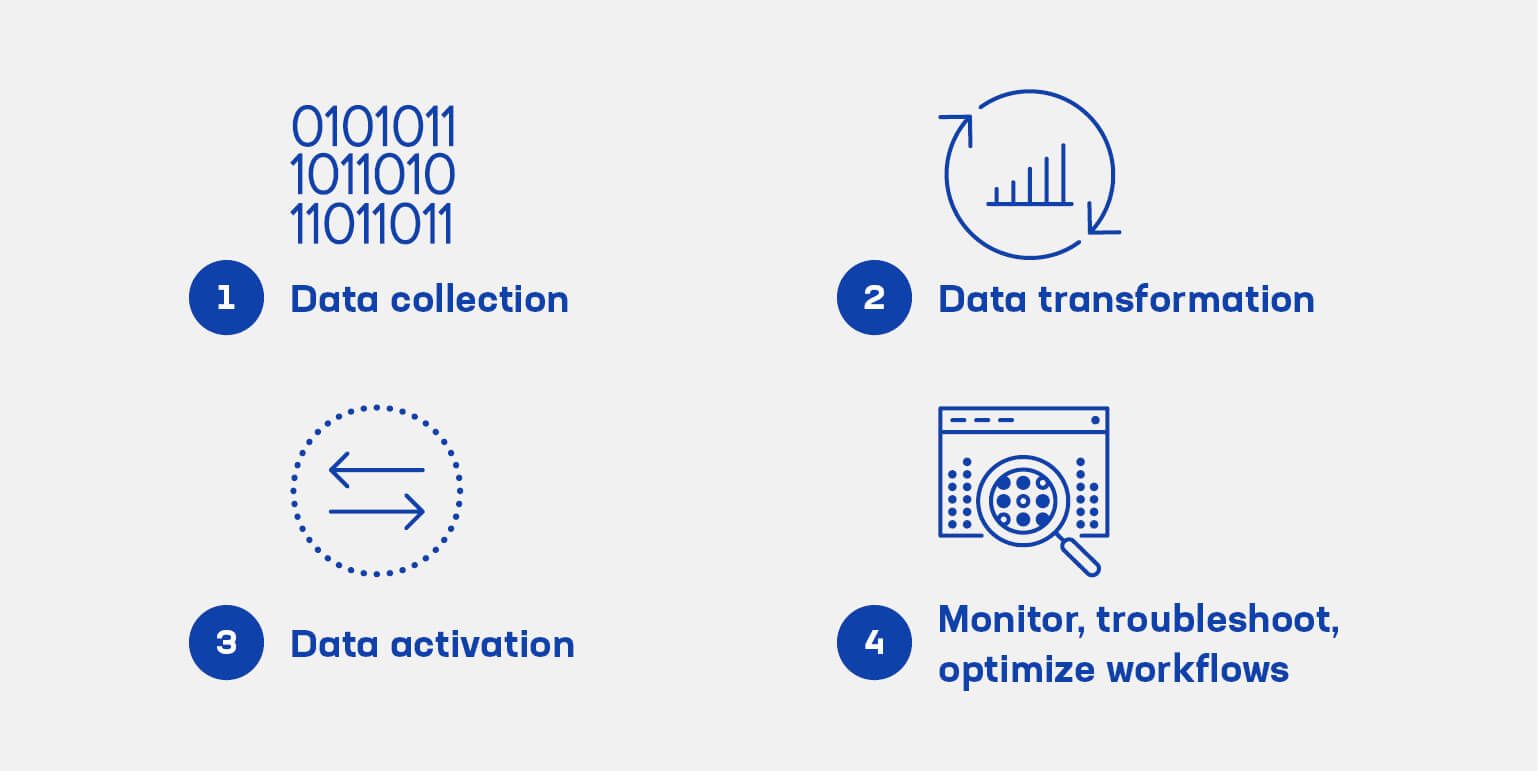
1. Ingérer et collecter les données : Se connecte aux bases de données, aux systèmes SaaS, aux journaux, aux API, aux appareils IoT et aux plateformes de streaming.
2. Transformer et standardiser les données : Applique aux données des opérations de validation du schéma, de nettoyage, de normalisation et d’enrichissement, ainsi que des contrôles qualité.
3. Activer et fournir les données : Achemine les données affinées vers les lacs de données, les entrepôts de données, les outils de BI, les systèmes opérationnels et les pipelines d’IA/ML.
4. Surveiller, dépanner et optimiser les workflows : Suit les performances, le lignage, l’actualisation des données et l’état des pipelines.
Les principaux composants d’un système d’orchestration des données sont les suivants :
- Moteur de workflow pour le séquençage des pipelines
- Connecteurs et frameworks d’intégration
- Gestion des métadonnées et traçabilité
- Contrôles qualité et application des politiques
- Observabilité et journalisation
- Gestion des erreurs et nouvelles tentatives
Comment F5 gère-t-il l’orchestration des données ?
F5 permet aux organisations d’exploiter des pipelines de données et d’IA orchestrés de manière sécurisée, fiable et à grande échelle, en renforçant l’infrastructure sous-jacente de gestion du trafic, des API et d’observabilité dont dépendent ces pipelines.
Distribution sécurisée et gouvernée des données : Les pipelines de données d’IA reposent sur des API, des services et des systèmes de stockage distribués. F5 protège ces flux grâce à l’inspection en ligne, à la gouvernance des API, au contrôle d’accès basé sur les rôles (RBAC) et à la gestion du trafic chiffré, garantissant ainsi que les données sensibles circulent de manière sûre et sécurisée dans les environnements hybrides et multicloud.
Connectivité optimisée et hautes performances : L’orchestration des données s’étend souvent sur plusieurs réseaux, clouds et applications. La F5 Application Delivery and Security Platform (ADSP) assure un routage à haut débit, un équilibrage de charge et une optimisation des performances afin de réduire la latence et d’éviter les goulets d’étranglement dans les pipelines.
Gouvernance de l’IA et protection adaptée aux modèles : F5 AI Guardrails applique des contrôles de politiques en temps réel en surveillant les requêtes, les réponses et les flux de données entre les applications et les modèles d’IA. Il empêche les fuites de données, bloque le trafic non sécurisé et garantit que seules les interactions conformes sont autorisées.
Visibilité unifiée sur les pipelines de données et d’IA : F5 AI Assistant offre une observabilité couvrant plusieurs environnements en analysant les journaux, la traçabilité, la télémétrie et les données de stratégie afin d’identifier les goulots d’étranglement et les problèmes de performances dans les pipelines distribués.
Avantages de la mise en œuvre de l’orchestration des données
L’orchestration des données offre des avantages opérationnels et stratégiques majeurs :
- Efficacité : Automatise les tâches manuelles et répétitives d’ingénierie des données, telles que l’ingestion, la transformation et la planification des pipelines, réduisant ainsi les efforts nécessaires et permettant aux équipes de se concentrer sur d’autres fonctions, comme l’analyse et le développement.
- Rapidité : Garantit un flux continu des données entre les systèmes, permettant des analyses en temps réel, des pipelines à haut débit et un accès plus rapide aux informations essentielles pour les activités métier et les charges de travail d’IA.
- Fiabilité : Garantit la cohérence des schémas, effectue des contrôles qualité et applique une logique de nouvelle tentative automatisée. Cela réduit les erreurs de données, les problèmes de pipeline et les perturbations en aval qui affectent les performances des analyses et des modèles.
- Évolutivité : Fournit une couche d’orchestration unifiée capable de coordonner des centaines, voire des milliers de pipelines dans des environnements hybrides et multicloud. À mesure que le volume et la vélocité des données augmentent, l’orchestration garantit des performances prévisibles des pipelines.
Cas d’usage de l’orchestration des données pour les entreprises
Les entreprises utilisent l’orchestration des données dans un large éventail de processus opérationnels et analytiques :
- Analyses et tableaux de bord en temps réel : Coordination des flux de données provenant des applications, des capteurs IoT et des transactions afin de fournir des informations instantanées
- Plateformes de gestion client et de personnalisation : Regroupez les données issues du CRM, des interactions sur le Web, des systèmes d’assistance et des outils marketing afin de fournir un profil client unifié.
- Détection de la fraude et évaluation des risques : Synchronise les journaux d’événements, les transactions, le comportement des utilisateurs et les données tierces dans des modèles de détection fonctionnant quasiment en temps réel.
- Visibilité et optimisation de la chaîne d’approvisionnement : Orchestre les données issues des systèmes logistiques, des bases de données d’inventaire et des appareils IoT afin d’optimiser les prévisions et les itinéraires.
- Pipelines de fonctionnalités d’IA/ML : Formulez, validez et transférez les données vers les environnements d’entraînement et d’inférence dans le cadre des workflows de ML.
- Rapports réglementaires : Automatise la préparation conforme des données pour les audits, les rapports financiers et les autres déclarations réglementaires du secteur.
Rôle de l’orchestration des données dans la gouvernance des données
L’orchestration des données renforce la gouvernance en intégrant des contrôles directement dans le cycle de vie des données :
- Traçabilité : Suit le parcours complet des données depuis le système source à travers toutes les étapes de transformation, offrant ainsi une visibilité essentielle pour les audits, le débogage et l’analyse des résultats des modèles.
- Contrôle d’accès : Applique les autorisations, le contrôle d’accès basé sur les rôles (RBAC) et les règles du moindre privilège à l’ensemble des pipelines, afin que les utilisateurs et les systèmes interagissent uniquement avec les données auxquelles ils sont autorisés à accéder.
- Pistes d’audit : Conserve des journaux détaillés sur les mouvements de données, les transformations, les approbations et les politiques, garantissant une traçabilité claire et facilitant la certification de conformité.
- Prise en charge des réglementations relatives à la protection de la vie privée : Automatise les contrôles tels que le masquage des données, la tokenisation, les demandes de suppression des données à caractère personnel (par exemple, dans le cadre du RGPD) et les politiques de conservation. L’orchestration garantit que les données sensibles sont traitées de manière cohérente dans l’ensemble des pipelines et des systèmes.
Définition et portée de l’orchestration de l’IA
L’orchestration de l’IA consiste à superviser, gérer et automatiser tous les éléments utilisés pour développer, déployer et maintenir les systèmes de machine learning et d’IA. Elle étend l’orchestration des données à l’ensemble du cycle de vie de l’IA en prenant en charge les pipelines de fonctionnalités, les processus d’entraînement, le packaging des modèles, le déploiement, la surveillance et l’amélioration.
L’orchestration de l’IA couvre les workflows d’opérations de machine learning (MLOps), la gouvernance des modèles, l’observabilité opérationnelle, la préparation de l’infrastructure et l’application des politiques dans les environnements hybrides et multicloud.
Composants clés d’un système d’orchestration de l’IA
Les systèmes d’orchestration de l’IA standardisent et automatisent chaque étape du cycle de vie du machine learning :
- Pipelines de données et de caractéristiques : Préparez, validez et fournissez des caractéristiques de données (des données de qualité et à jour) aux environnements d’entraînement et d’inférence.
- Orchestration de l’entraînement : Planifie les tâches d’entraînement, configure les ressources de calcul (GPU/CPU), gère la planification des environnements d’entraînement distribué et assure le suivi de l’entraînement des modèles.
- Déploiement de modèles : Automatise le packaging et la gestion des versions des modèles, les déploiements de test et en production, ainsi que le routage nécessaire à l’inférence en temps réel.
- Surveillance et analyse des performances : Suit la dérive du modèle, sa précision, sa latence, l’utilisation des ressources et les modifications des données d’entrée afin de garantir sa fiabilité en production.
- Boucles de rétroaction : Collecte les prédictions, les résultats, les interactions des utilisateurs et les données de télémétrie du modèle afin de faciliter le réentraînement, l’ajustement et l’apprentissage continu.
Principaux avantages de la mise en œuvre de l’orchestration de l’IA
L’orchestration de l’IA simplifie et renforce les opérations d’IA en entreprise :
- Livraison reproductible de solutions d’IA : Les workflows standardisés réduisent le recours aux scripts ponctuels et aux processus manuels, ce qui rend le développement et le déploiement de l’IA cohérents et prévisibles, tout en éliminant les erreurs humaines.
- Opérations d’IA gouvernées : Offre une visibilité sur la traçabilité des modèles, les approbations, la consommation des données et la gestion des versions afin de garantir une utilisation responsable et conforme de l’IA.
- Pipelines fiables et prêts pour la production : Garantissent des performances constantes des modèles, une latence adaptée et une surveillance automatisée afin d’éviter les défaillances.
- Cycles d’itération plus rapides : Simplifie le réentraînement, la validation et le déploiement, accélérant ainsi l’innovation et réduisant le délai de création de valeur des fonctionnalités d’IA.
- Opérations multimodèles évolutives : Coordonne les charges de travail entre différents clouds, sites en périphérie et environnements informatiques, afin de prendre en charge les portefeuilles d’IA.
Plateformes d’orchestration de l’IA ou automatisation générique des workflows
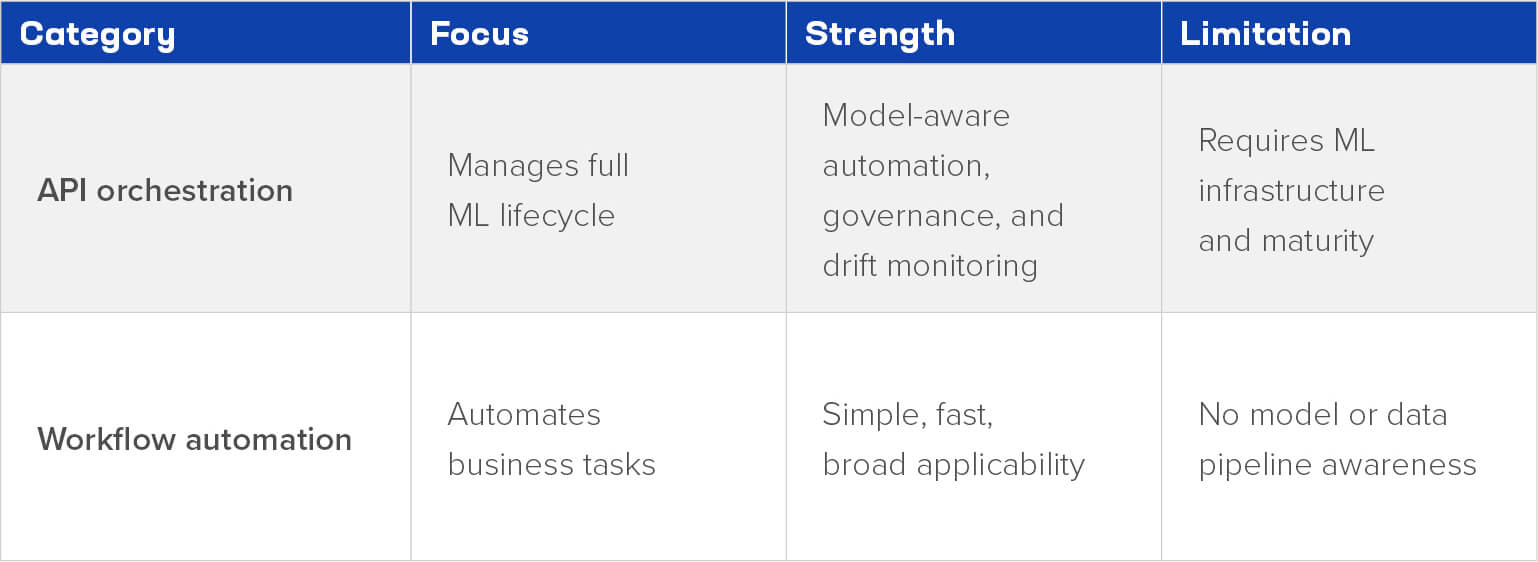
Les plateformes d’orchestration de l’IA sont spécialement conçues pour le machine learning et l’IA générative. Elles comprennent les exigences liées au cycle de vie des modèles, assurent une surveillance propre à chaque modèle, prennent en charge l’entraînement distribué et garantissent la sécurité et la conformité des systèmes d’IA.
Les fonctionnalités comprennent généralement :
- Intégration d’un feature store
- Traçabilité et gestion des versions des modèles
- Planification des GPU/accélérateurs
- Détection de la dérive et réentraînement automatisé
- Contrôles des politiques et de la gouvernance
- Gestion du trafic d’inférence
L’automatisation générique des workflows, quant à elle, englobe les moteurs de workflow traditionnels (par exemple, la gestion des processus métier, les ordonnanceurs, etc.) qui automatisent les processus métier, mais ne disposent pas de fonctionnalités de machine learning. Ils ne suivent pas l’entraînement, ne surveillent pas la dérive des modèles, ne gèrent pas l’infrastructure GPU et n’appliquent pas de règles de gouvernance propres aux modèles.
Cas d’usage de l’orchestration de l’IA en entreprise et impact sur la transformation numérique
Les entreprises utilisent l’orchestration de l’IA pour déployer leurs programmes d’IA à grande échelle, au-delà du stade de la preuve de concept :
- Déploiement automatisé des modèles dans les différentes unités opérationnelles : Permet de déployer de manière cohérente des solutions reposant sur des modèles de détection de la fraude, des moteurs de tarification ou des modèles de prévision de la demande.
- Personnalisation et recommandations en temps réel : Gère l’ingestion des données, les mises à jour de l’entraînement et les points de terminaison d’inférence afin de proposer des expériences personnalisées à grande échelle.
- Maintenance prédictive et analyse de l’IoT : Gère les flux de données en continu et les pipelines d’inférence capables de détecter les anomalies, de prévoir les défaillances et d’optimiser les performances.
- IA conversationnelle et applications génératives : Orchestre les bases de données, les pipelines de recherche d’informations, la gouvernance des prompts et les services de modèles afin de soutenir les opérations clients.
- Transformation de l’entreprise par l’IA : L’orchestration de l’IA pose les bases de workflows d’IA reproductibles, conformes et gouvernés, permettant aux organisations d’intégrer l’IA à leurs processus métier, et pas seulement à des systèmes isolés.
Gouvernance et conformité dans l’orchestration de l’IA
L’orchestration de l’IA intègre directement la gouvernance aux opérations des modèles, afin de garantir que l’IA d’entreprise reste sûre, responsable et conforme.
- Suivi des données : Surveille les jeux de données, les caractéristiques, les transformations et les sources de données afin d’empêcher toute utilisation non autorisée et de garantir leur traçabilité à des fins d’audit.
- Suivi des modèles : Consigne les versions des modèles, les données d’entraînement, les configurations, les performances, les approbations et l’historique des déploiements, afin de garantir la transparence et la conformité réglementaire.
- Suivi des décisions : Consigne les résultats d’inférence, les explications et les décisions, permettant ainsi une évaluation complète de l’impact du modèle, des biais et de l’équité.
- Politiques et contrôles d’accès : Appliquez des autorisations basées sur les rôles, le masquage des données et une gouvernance des API afin de garantir que seuls les systèmes et utilisateurs autorisés puissent interagir avec les modèles ou les données sensibles.
- Préparation à la conformité réglementaire : Facilite la conformité aux réglementations relatives à l’IA (par exemple, le règlement de l’Union européenne sur l’intelligence artificielle (règlement sur l’IA de l’UE), le cadre de gestion des risques liés à l’intelligence artificielle du National Institute of Standards and Technology (NIST AI RMF) ou les réglementations propres au secteur) en garantissant l’auditabilité et la traçabilité tout au long du cycle de vie de l’IA.
Orchestration des données | FAQ
Qu’est-ce que l’orchestration des données et comment fonctionne-t-elle, étape par étape ?
L’orchestration des données automatise le déplacement, la transformation et la mise à disposition des données dans des systèmes distribués. Elle suit généralement quatre étapes :
- Ingérez et collectez des données provenant de bases de données, d’applications SaaS, de journaux, de services de streaming et d’API.
- Transformez et standardisez les données à l’aide de règles de validation, de normalisation, d’enrichissement et de mise en forme.
- Activez et transmettez les données aux entrepôts et lacs de données, aux applications, aux plateformes d’analyse et aux systèmes de machine learning.
- Surveillez et optimisez les pipelines en suivant la fraîcheur, la qualité, la traçabilité et l’état opérationnel des données.
En quoi l’orchestration des données diffère-t-elle de l’intégration des données et des outils ETL ?
L’intégration des données connecte les systèmes ; les outils ETL extraient, transforment et chargent les données, souvent par lots. L’orchestration des données gère ces workflows dans des environnements de traitement par lots, de streaming, de cloud et d’IA, garantissant ainsi la fiabilité des pipelines grâce à une gouvernance appropriée, à des contrôles qualité et à une surveillance continue.
Quels sont les principaux composants d’un système d’orchestration des données ?
Une plateforme d’orchestration classique comprend :
- Moteur de workflow pour la planification et la gestion des dépendances
- Connecteurs et frameworks d’intégration pour l’ingestion
- Solutions de gestion des métadonnées et de traçabilité pour suivre les données
- Validation de la qualité et application des politiques
- Observabilité et journalisation des performances du pipeline
- Gestion des erreurs et logique de nouvelle tentative
Quels sont les principaux avantages et cas d’usage de l’orchestration des données pour les entreprises ?
Les avantages comprennent une efficacité accrue, un accès plus rapide aux informations, une fiabilité améliorée et une meilleure évolutivité dans les environnements hybrides. Les cas d’usage incluent les tableaux de bord en temps réel, les systèmes clients, la détection des fraudes, l’analyse de la chaîne d’approvisionnement, le reporting réglementaire et les pipelines d’entraînement de l’IA et du machine learning.
Qu’est-ce que l’orchestration de l’IA et quel est son lien avec l’orchestration des données et le MLOps ?
L’orchestration de l’IA gère l’ensemble du cycle de vie du machine learning, notamment la préparation des données, l’entraînement, le déploiement, la surveillance et l’amélioration, en coordonnant les composants qui transforment les données en modèles et assurent la mise en production de ces derniers. Elle s’appuie sur le MLOps pour renforcer la gouvernance, l’automatisation et le suivi du cycle de vie.
Quels sont les outils et plateformes couramment utilisés pour l’orchestration des données et de l’IA ?
Les outils standard d’orchestration des données comprennent Apache Airflow, Dagster, Prefect et les planificateurs natifs du cloud. Les plateformes d’orchestration de l’IA comprennent MLflow, Kubeflow, Vertex AI Pipelines, SageMaker Pipelines, Databricks Workflows et des solutions MLOps spécialisées. La plupart des entreprises utilisent une combinaison adaptée à leur pile de données, à leur fournisseur de services cloud et/ou à leur stratégie en matière de modèles.
Quels sont les principaux défis liés à la mise en œuvre de l’orchestration de l’IA, et comment les équipes peuvent-elles les relever ?
Les défis comprennent la fragmentation des données, le manque de cohérence de l’entraînement, l’absence de visibilité sur la traçabilité, le déploiement manuel, la dérive des modèles et les biais, ainsi que les problèmes de conformité. Les équipes peuvent y remédier en adoptant des pipelines standardisés, en mettant en œuvre des outils de traçabilité et d’observabilité, en automatisant le déploiement, en appliquant des politiques de gouvernance et en assurant une surveillance tout au long du cycle de vie.
Comment l’orchestration des données et de l’IA favorise-t-elle la gouvernance et la conformité ?
Elles intègrent la gouvernance aux workflows en assurant le suivi de la traçabilité des données, des contrôles d’accès, des transformations de données et des pistes d’audit, ainsi que la validation de l’utilisation des données par les modèles. Dans le cadre de l’orchestration de l’IA, cela comprend le suivi des versions des modèles, des données, des décisions et des performances afin de favoriser la transparence et la conformité.
Par où les entreprises doivent-elles commencer si elles découvrent l’orchestration des données et de l’IA ?
Les organisations devraient commencer par quelques pipelines à fort impact, tels que ceux dédiés aux fonctionnalités clés ou aux workflows analytiques, avant d’étendre progressivement leur périmètre. La mise en place précoce de métadonnées centralisées, de la traçabilité des données et de contrôles qualité permet de réduire la complexité. Les équipes devraient également évaluer les outils d’orchestration compatibles avec leur stratégie cloud et adopter des cadres de gouvernance évolutifs pour les charges de travail liées aux données et à l’IA.
Comment F5 peut vous aider
L’orchestration des données et de l’IA est essentielle aux stratégies modernes. Elle garantit la fiabilité et l’automatisation des pipelines à mesure que les entreprises développent l’analyse en temps réel, déploient des modèles plus volumineux et adoptent des environnements multicloud. Elle assure une circulation fluide des données, des données d’entrée de haute qualité et un comportement cohérent de l’IA. La réussite repose sur une infrastructure robuste, notamment sur les réseaux de données, la sécurité et les technologies de diffusion. Sans gestion résiliente du trafic, points de terminaison sécurisés et visibilité, même les plateformes avancées peinent à supporter la charge.
L’orchestration repose sur des fondations solides. Une gestion résiliente du trafic permet de faire évoluer les services de données et de modèles. La sécurité des API garantit la gouvernance et protège les données sensibles. Une observabilité unifiée offre une visibilité sur les performances, les dérives, les erreurs et les comportements dans l’ensemble des environnements, permettant ainsi aux équipes d’exploiter les pipelines en toute confiance.
Les entreprises devraient se poser les questions suivantes : les pipelines sont-ils fiables en cas de forte charge ? La gouvernance est-elle cohérente ? Les problèmes peuvent-ils être suivis d’un cloud à l’autre ? Les équipes chargées des réseaux, de la sécurité et de la livraison sont-elles en phase avec celles responsables des données et de l’IA ? Si les réponses sont « non » ou « pas sûr », il convient d’envisager de repenser l’orchestration et l’infrastructure comme un système unifié.
Pour en savoir plus, rendez-vous sur f5.com.
